Khi AI bước vào những nhiệm vụ dài hơi
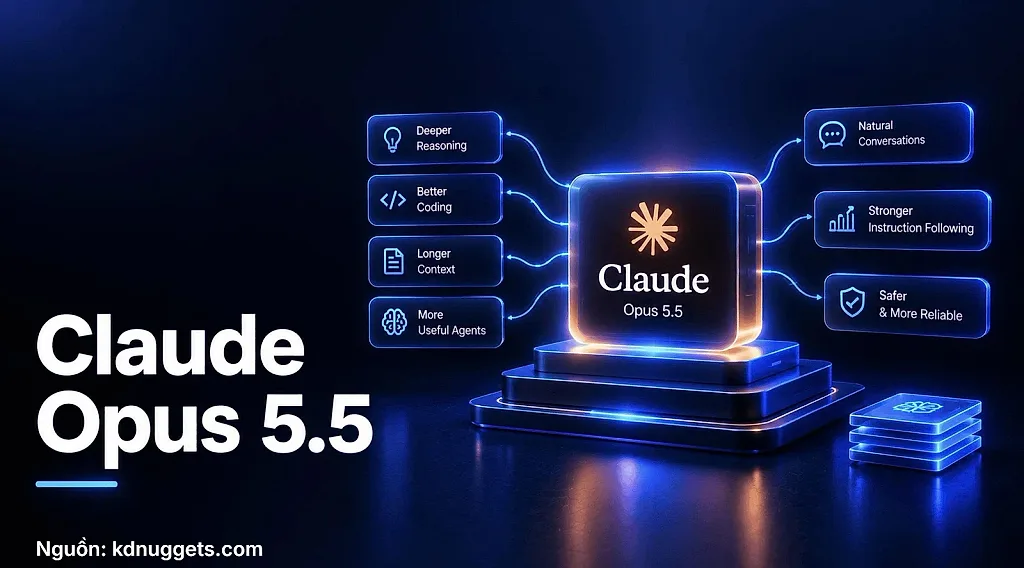
Anthropic phát hành Claude Opus 5.5 ngày 22/9/2026, định vị đây là mô hình dành cho lập trình tác tử kéo dài và các công việc tri thức phức tạp. Mô hình có cửa sổ ngữ cảnh 1 triệu token, tối đa 128.000 token đầu ra, cơ chế suy luận thích ứng luôn bật và mức giá 4 USD cho mỗi triệu token đầu vào, 20 USD cho mỗi triệu token đầu ra.
Anthropic cho biết, Opus 5.5 dẫn đầu trong các bài đánh giá về lập trình tác tử, sử dụng máy tính và công việc tri thức. Trên Terminal-Bench 4.0, mô hình đạt 66,4%; FrontierCode v1.1 đạt 54,4%; CursorBench 4.0 đạt 57,8%. Ở GDPval-AA v2.1, chỉ số đánh giá công việc tri thức, Opus 5.5 đạt 1.846 điểm.
Tuy nhiên, các số liệu này chủ yếu do Anthropic công bố. Công ty cũng lưu ý phần lớn kết quả được thực hiện ở mức suy luận cao nhất, trong khi một số số liệu của đối thủ được chạy ở mức nỗ lực khác. Với Terminal-Bench 4.0, Opus 5.5 được đánh giá ở mức xhigh, còn GPT-6 Astra sử dụng mức high.
Anthropic cho biết, Opus 5.5 có thể xử lý các công việc kéo dài như chuyển đổi toàn bộ mã nguồn, kiểm toán cơ sở mã lớn và sửa lỗi trên nhiều tệp. Trong một thử nghiệm nội bộ, mô hình kiểm toán và sửa cơ sở mã 200.000 dòng trong chưa đầy 3 giờ, trong khi Opus 5 cần hơn 20 giờ và sử dụng số token gấp 2,5 lần.
Bảng điểm cao chưa đồng nghĩa bước nhảy lớn
METR, tổ chức chuyên đánh giá các hệ thống AI tiên tiến, đã thực hiện một cuộc đánh giá trước khi phát hành Opus 5.5. Nhóm nghiên cứu sử dụng quyền truy cập API trong 10 ngày làm việc và kiểm tra 5 nhóm nhiệm vụ, gồm huấn luyện mô hình ngôn ngữ, lập trình, nghiên cứu mở và xây dựng tác tử chơi trò chơi.
METR kết luận, Opus 5.5 có khả năng tạo ra mức tăng năng suất nhỉnh hơn Claude Fable 5.1, nhưng không phải một bước nhảy lớn. Theo nhóm nghiên cứu, mô hình vẫn có những điểm yếu về khả năng dự báo, tự xây dựng vòng phản hồi và phán đoán trong các nhiệm vụ dài. METR cũng cho rằng, Opus 5.5 chưa có khả năng tự động hóa hoàn toàn hoạt động nghiên cứu và phát triển AI.
Một bài kiểm tra thực hành của Analytics Vidhya cho kết quả tương tự. Opus 5.5 đọc chính xác một biểu đồ nhiều dữ liệu, nhận diện đúng các con số chính và phát hiện vấn đề trong cách đặt câu hỏi. Tuy nhiên, mô hình vẫn suy đoán nguyên nhân khi dữ liệu chưa đủ cơ sở và mắc lỗi cộng số ở một nhóm nhãn năm 2021.
Trong một bài kiểm tra khác, mô hình chuyển ghi chú cuộc họp thành bản cập nhật ngắn gọn nhưng bỏ sót một chi tiết quan trọng. Kết quả cho thấy, Opus 5.5 làm tốt việc sắp xếp và trình bày thông tin, nhưng vẫn cần con người kiểm tra khi phải diễn giải dữ liệu hoặc đưa ra kết luận.
Chi phí thấp mở rộng dư địa ứng dụng
Tuy nhiên, mức giảm 40% phụ thuộc vào loại công việc và thiết lập suy luận. Analytics Vidhya lưu ý rằng, phần lớn điểm benchmark cao nhất được đo ở mức nỗ lực tối đa, trong khi tuyên bố về chi phí thường dựa trên mức mặc định. Người dùng có thể đạt chất lượng cao hơn nhưng phải trả nhiều hơn nếu tăng mức suy luận.
Claude Opus 5.5 cũng có một số thay đổi kỹ thuật đáng chú ý: suy luận thích ứng không thể tắt, các khối suy luận gắn với mô hình và cuộc trò chuyện, trong khi một số công cụ sử dụng máy tính cũ không còn được chấp nhận trên API. Các nhóm đang chạy Opus 5 cần kiểm tra khả năng tương thích trước khi chuyển sang phiên bản mới.
Claude Opus 5.5 phù hợp với những công việc cần xử lý mã nguồn lớn, nhiều bước và kéo dài. Mức giá thấp hơn, cửa sổ ngữ cảnh lớn và khả năng sử dụng ít token hơn có thể tạo lợi thế cho doanh nghiệp và nhóm phát triển phần mềm.